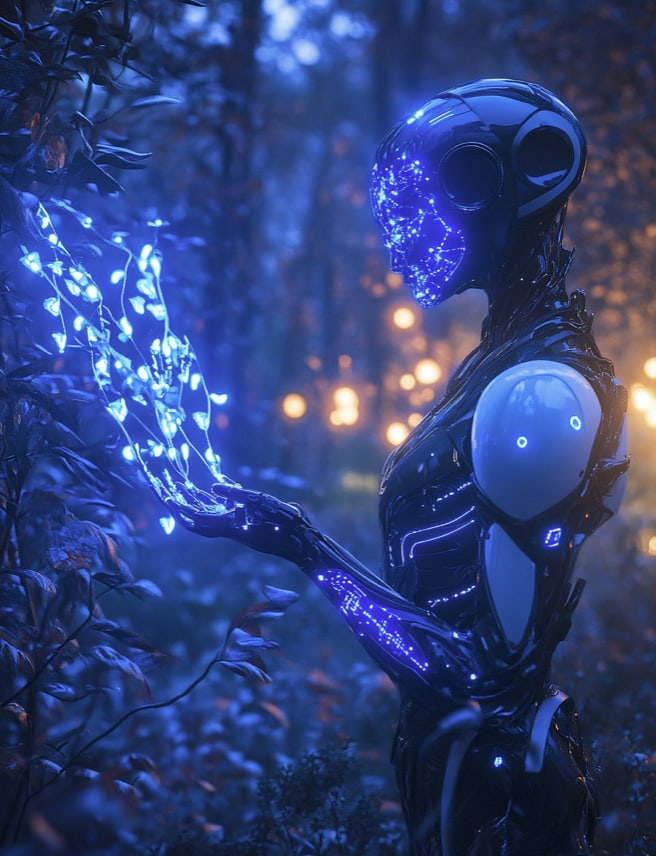
Cosa è
l'AI generativa
Per capirla davvero, prima vediamo come funziona.
Corso AI, RAG e LLM Locali · Alessandro Caprai
Partiamo dalla definizione
“L'AI generativa è un tipo di intelligenza artificiale che crea contenuti nuovi, testo, immagini, musica o video, a partire da ciò che ha imparato dai dati.”
Risposta di ChatGPT alla domanda «cosa è l'AI generativa», 2025.
Come nasce un'immagine
Si scrive una frase, l'AI disegna il resto
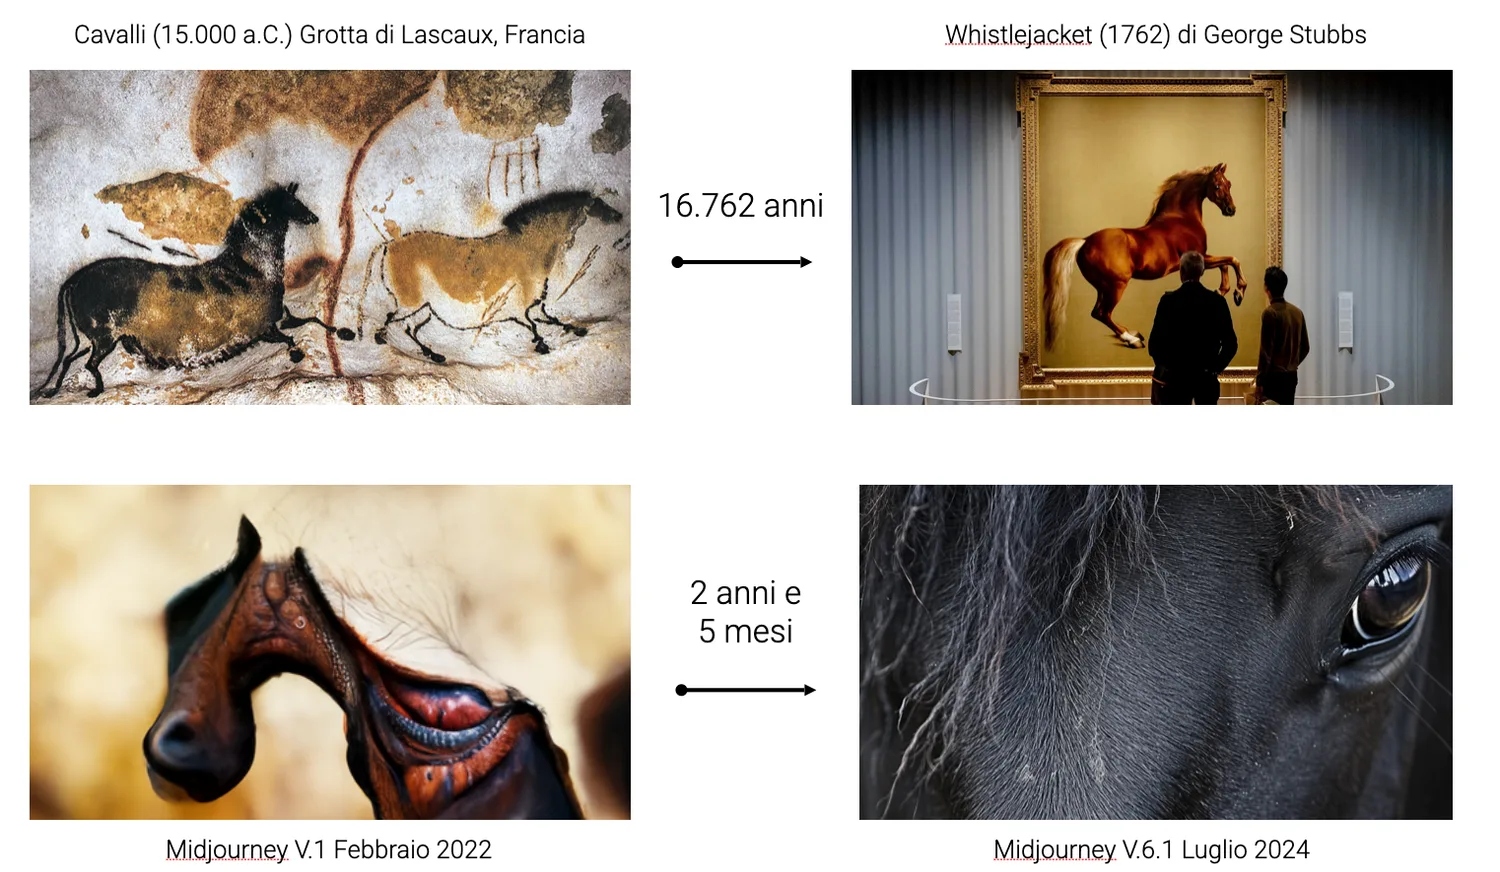
Per creare l'immagine che vedremo tra poco abbiamo dato a un'AI un comando di tre parole in inglese: «close up horse face», cioè «primo piano del volto di un cavallo». Nessuna macchina fotografica, nessuno scatto.
Quell'immagine non esisteva da nessuna parte. Il software l'ha costruita da zero, a partire da quella frase, come promette la definizione di prima.
Lo stesso comando
Due anni di Midjourney
Midjourney è un'AI che crea immagini. Le abbiamo chiesto lo stesso primo piano di cavallo a due anni di distanza: nessuno ha ridisegnato niente, è migliorato il software.
Immagini generate con Midjourney, dalla V.1 alla V.6.1.
L'evoluzione non si ferma
I limiti di oggi non sono i limiti di domani
I modelli non stanno fermi: migliorano in fretta, una versione dopo l'altra. Un compito che oggi l'AI sbaglia, o che non sa proprio affrontare, con il modello successivo può diventare semplice.
Conviene non dare mai un giudizio definitivo: quello che oggi sembra un muro, tra pochi mesi potrebbe non esserlo più. Vale la pena riprovare ogni tanto.
Perché ci interessa
Per correre in MotoGP non basta saper guidare
Per andare in moto la domenica non serve sapere cosa succede dentro al motore. Un pilota da corsa, invece, lo conosce pezzo per pezzo: è lì, nei dettagli, che si guadagna il decimo di secondo.
Con l'AI vale lo stesso. Usarla per svago è una cosa, lavorarci è un'altra. Questo corso è per chi la usa per mestiere, e quindi deve sapere cosa ha sotto il cofano.
Molto semplificata
Costruire un'AI è come fare il pane
Il principio è il machine learning: impara dai dati, non da regole scritte.
I pezzi, messi insieme, fanno il modello: non una sequenza in fila.
Tocca un blocco per una prima descrizione.
Il principio, da vicino
Le due declinazioni del machine learning
Semplificato: il deep learning è machine learning anche lui.
Tocca un blocco per una prima descrizione.
Tokenizzazione
Le parole diventano numeri
Per noi «Pizza» è una parola di sei lettere. Il computer non la legge così.
I numeri qui sono di esempio.
Token ID · Il vocabolario
Come l'AI «legge» il linguaggio
C'è un istante preciso in cui la parola umana viene tradotta nella lingua madre dell'AI: la matematica.
I modelli come GPT o Claude non conoscono l'alfabeto e non leggono le lettere. Per elaborare il testo hanno bisogno solo di numeri: vettori e calcoli.
Il ponte è il Token ID: a ogni frammento di testo è assegnato un codice numerico unico.
I codici vivono in un grande vocabolario, un catalogo chiuso deciso una volta durante l'addestramento. Dentro c'è ogni pezzo possibile: parole intere, sillabe, singole lettere, punteggiatura e perfino gli spazi.
I codici qui sono di esempio.
Token ID · Il processo
Anatomia della traduzione: taglio e assegnazione
Quando invii un prompt, la conversione avviene in due fasi.
Fase 1, il taglio. Un algoritmo scompone la frase in fette ottimali, i token. Non sempre coincidono con le parole: a volte è un pezzo, a volte una parola intera.
Fase 2, l'assegnazione. Il modello confronta ogni fetta con il suo catalogo interno e la sostituisce con il numero di matricola, il Token ID.
Perché tanta fatica? Perché i numeri sono veloci da calcolare e compatti da tenere in memoria: è così che il modello regge frasi lunghe senza perdere il filo.
# esempio di mapping internoinput_text = "L'Intelligenza Artificiale"tokens = ["L'", "Intelligenza", " Artificiale"]token_ids = [432, 18954, 32011]Codice e numeri qui sono di esempio.
Token ID · L'embedding
La matrice del significato
Un Token ID è solo un'etichetta: 8021 non «vale» più di 3390. Il significato arriva da questa tabella, dove ogni parola diventa una riga di numeri, le sue coordinate: parole simili finiscono con righe vicine.
| Parola | Token IDl'etichetta | Il vettorele coordinate del significato | Vicino anello spazio |
|---|---|---|---|
| «Pizza» | 8021 | 0,12 -0,44 0,98 … | Pasta, Focaccia |
| «Pasta» | 8042 | 0,11 -0,41 0,95 … | Pizza, Risotto |
| «Cane» | 3390 | 0,70 0,55 -0,60 … | Gatto, Cavallo |
Che cos'è questa tabella
Uno strato della rete neuralela rete lo impara da sé, nessuno lo scrive a mano
Le coordinate qui sono di esempio: in un modello vero ogni parola ne ha centinaia o migliaia.
L'attenzione
I Transformer Layers: le relazioni e il contesto
Mentre l'Embedding definisce il significato della singola parola, i Transformer Layers calcolano l'attenzione e il contesto tra le parole della frase per capire il senso generale.
La frase: «In Italia la pizza si cuoce nel forno»
Ogni riga dice quanto una parola guarda le altre. «Pizza», «cuoce» e «forno» si illuminano a vicenda: il modello coglie che vanno insieme. Valori di esempio, una mappa reale ha molte teste e molti strati.
Approfondimento
Machine Learning Classico
Come le macchine imparano
Machine Learning Classico
Guardiamolo tutto insieme
Il metodo classico
L'addestramento, in due modi
Semplificato: sono due famiglie, e a volte si combinano.
Tocca un blocco per una prima descrizione.
Il K-Means
Non supervisionato: raggruppa da solo
| Giocatore | Gol | Assist | Passaggi | Corsa | Contrasti | Parate |
|---|---|---|---|---|---|---|
| Ronaldo | 98 | 80 | 55 | 60 | 10 | 0 |
| De Bruyne | 55 | 95 | 90 | 85 | 30 | 0 |
| Rüdiger | 5 | 10 | 45 | 65 | 92 | 0 |
| Buffon | 0 | 0 | 15 | 15 | 0 | 98 |
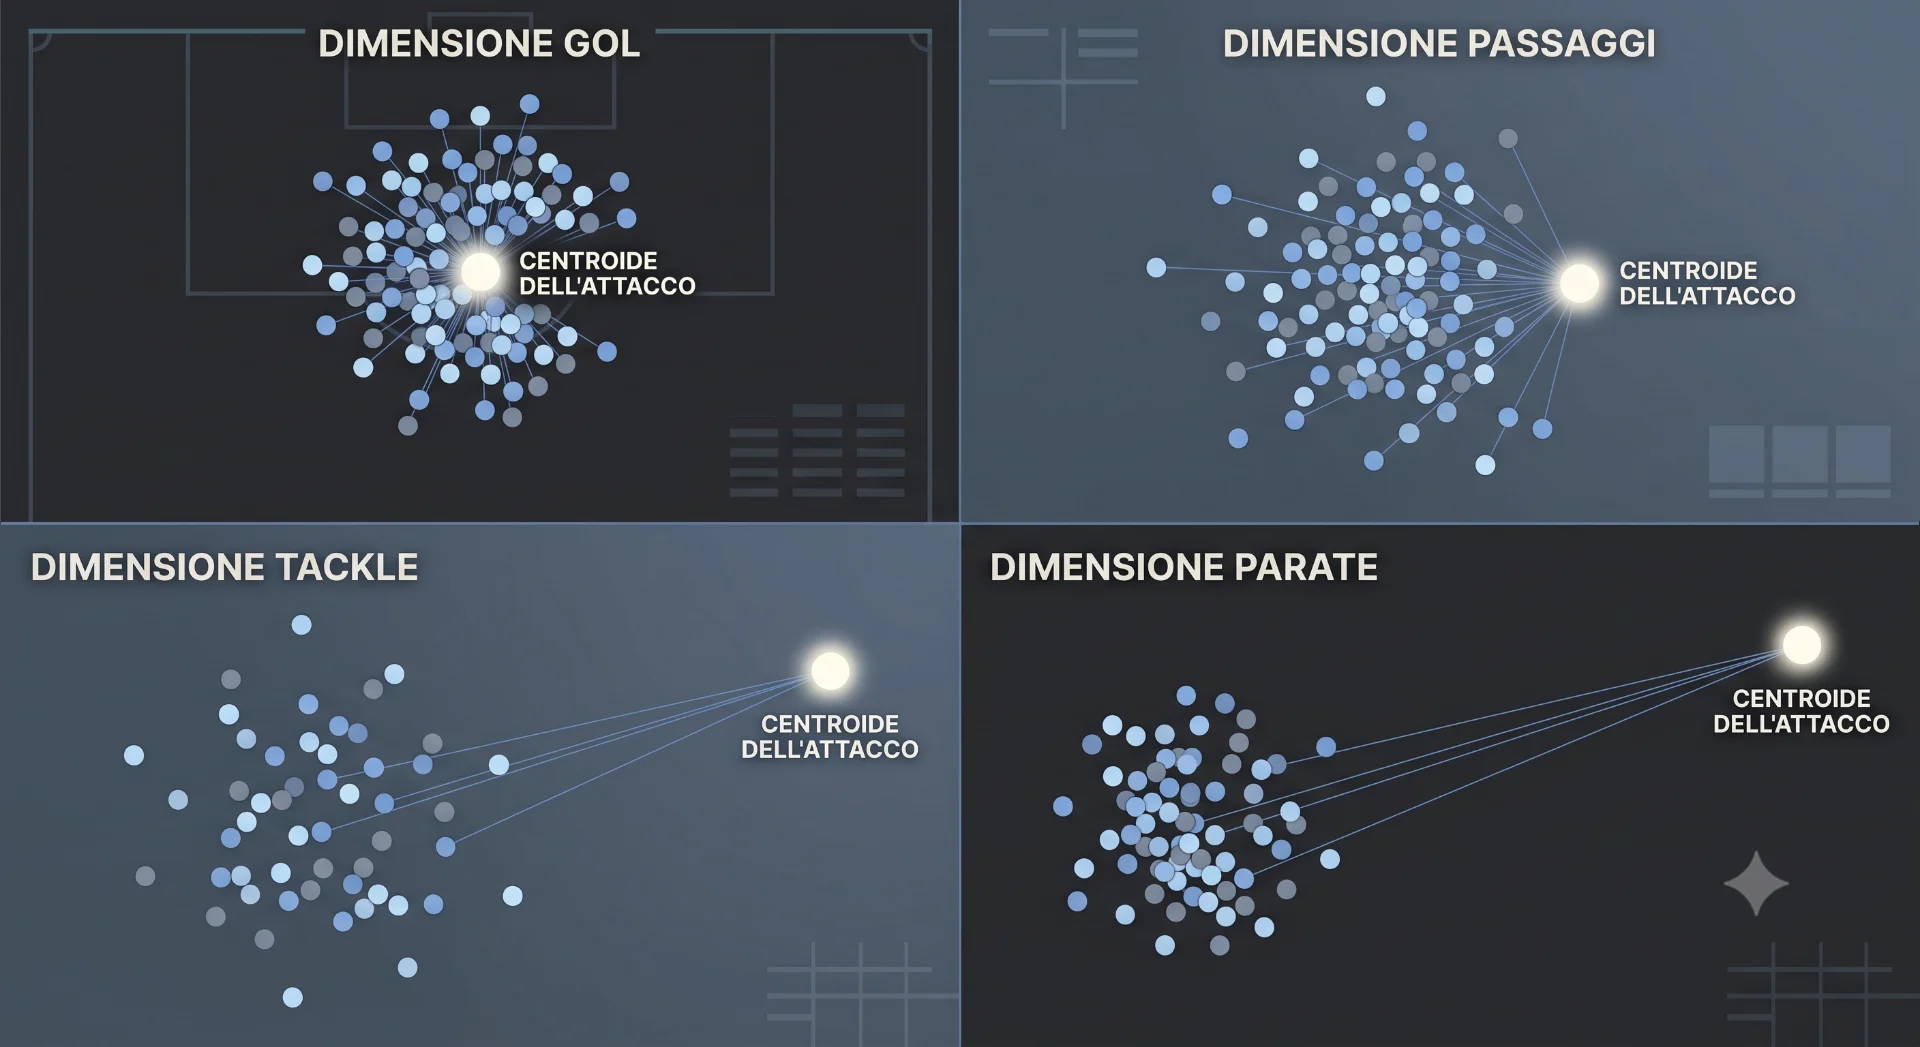
Solo numeri, nessun ruolo: con sei cifre a testa (gol, parate, contrasti...) ritrova da solo i quattro gruppi, portieri, difensori, centrocampisti, attaccanti.
La matematica delle distanze
Due concetti opposti
Un sì e un no dicono il contrario, e infatti stanno ai due capi, lontani. Il primo passo è questo: dare al significato una posizione.
La matematica delle distanze
Due concetti opposti
Avverbi
Anche gli avverbi vanno da un sì a un no, ma in un vicinato tutto loro, più piccolo. Dentro una dimensione se ne apre un'altra.
La matematica delle distanze
Due concetti opposti
Avverbi
Avverbi affermativi
«Sicuro», «certamente» e «sì» dicono quasi la stessa cosa, e si stringono vicini; «no» resta lontano. Vicino vuol dire simile: è così che il computer misura il significato.
Con le etichette
Supervisionato: impara dagli errori
| Giocatore | Gol | Assist | Passaggi | Corsa | Contrasti | Parate | Ruolola scrive l'umano |
|---|---|---|---|---|---|---|---|
| Ronaldo | 98 | 80 | 55 | 60 | 10 | 0 | Attaccante |
| De Bruyne | 55 | 95 | 90 | 85 | 30 | 0 | Centrocampista |
| Rüdiger | 5 | 10 | 45 | 65 | 92 | 0 | Difensore |
| Buffon | 0 | 0 | 15 | 15 | 0 | 98 | Portiere |
Alla fine ha le regole in mano: parate alte, è un portiere; tanti gol, un attaccante.
Apprendimento classico
I due metodi a confronto
Non è che uno sia meglio dell'altro: servono a cose diverse.
L'inferenza
La prova del nove
Finito l'addestramento su quel dataset, arriva un giocatore mai visto. Il modello legge solo i suoi numeri e deve dire il ruolo.
| Giocatore | Gol | Assist | Passaggi | Corsa | Contrasti | Parate | Ruoloda indovinare |
|---|---|---|---|---|---|---|---|
| Giocatore X | 12 | 30 | 94 | 89 | 40 | 0 | ? |
La macchina risponde
Centrocampista98,4% di sicurezza
Era Tony Kroos, un centrocampista, e il modello non l'aveva mai visto: ha deciso solo dai numeri. Un caso di prova, un numero illustrativo.
Prima dei metodi, i dati
Un dataset di esempio: i calciatori
Ogni riga è un giocatore ridotto a sei numeri, più il ruolo.
| Giocatore | Gol | Assist | Passaggi | Corsa | Contrasti | Parate | Ruolo |
|---|---|---|---|---|---|---|---|
| Messi | 95 | 92 | 65 | 50 | 15 | 0 | Attaccante |
| Ronaldo | 98 | 80 | 55 | 60 | 10 | 0 | Attaccante |
| Pirlo | 20 | 85 | 98 | 82 | 35 | 0 | Centrocampista |
| De Bruyne | 55 | 95 | 90 | 85 | 30 | 0 | Centrocampista |
| Bastoni | 8 | 25 | 65 | 60 | 88 | 0 | Difensore |
| Rüdiger | 5 | 10 | 45 | 65 | 92 | 0 | Difensore |
| Buffon | 0 | 0 | 15 | 15 | 0 | 98 | Portiere |
| Donnarumma | 0 | 0 | 20 | 15 | 0 | 94 | Portiere |
Il ruolo è l'etichetta, la risposta giusta scritta da una persona: il supervisionato la usa, il non supervisionato deve farne a meno. Otto dei quattordici giocatori del dataset.
Lavagna
Disegniamo insieme
Uno spazio libero per spiegare con uno schizzo. Scegli il colore, disegna o scrivi in una casella di testo, torna indietro sull'ultimo tratto, e se vuoi salva il disegno e riguardalo come un piccolo video.
Approfondimento
Deep Learning
Oltre i limiti del machine learning classico
Deep learning · Il ruolo umano
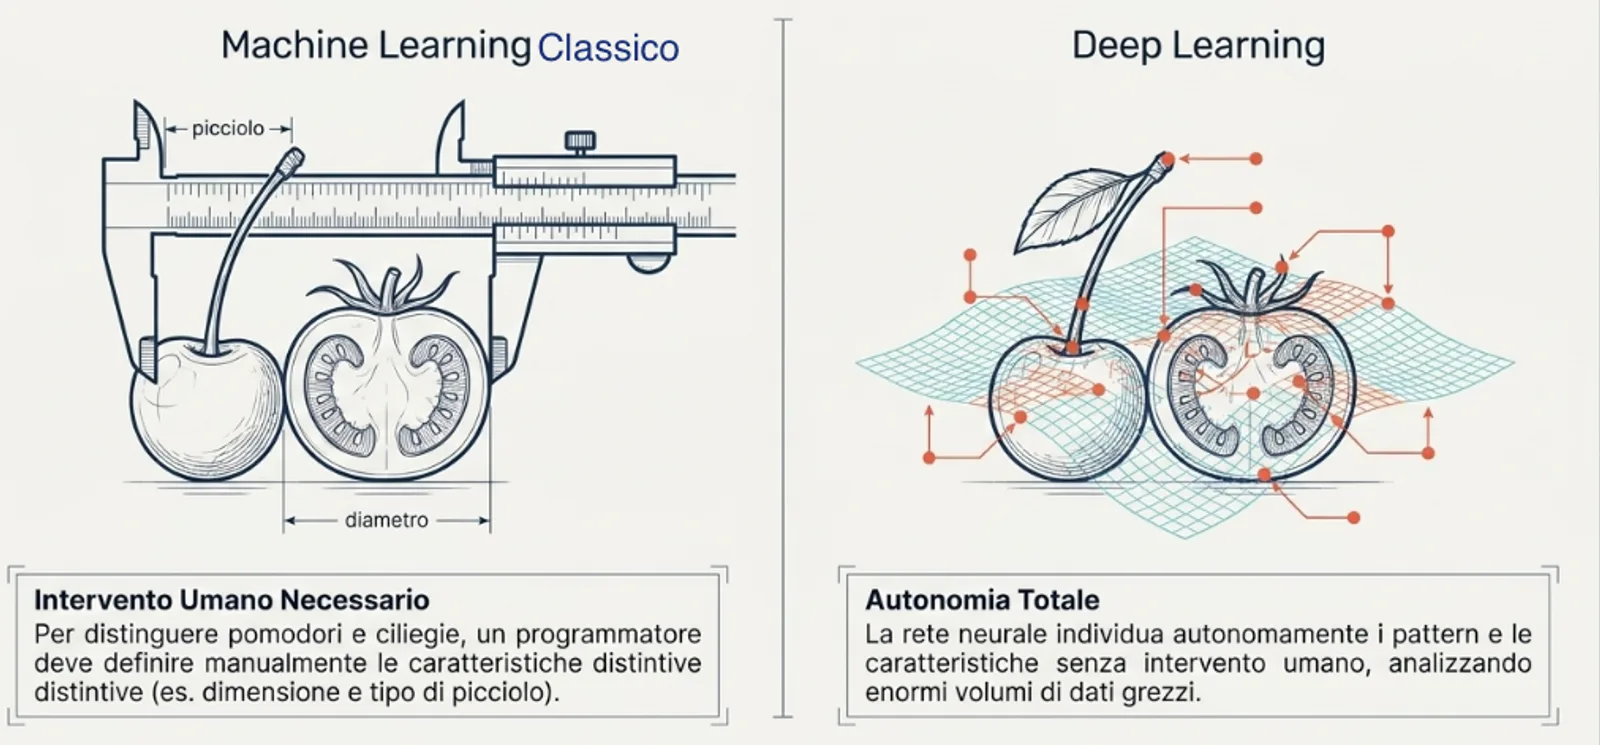
L'intervento umano non sparisce, si sposta
Meno lavoro manuale sui dettagli, più responsabilità sulle scelte: la persona sale di livello, non esce di scena.
Deep learning · L'intervento umano
Curare i dati
Se entra spazzatura, esce spazzatura.
Dati sintetici
Il muro dei dati
Gli istituti di ricerca, come Epoch AI, stimano che le grandi aziende tech abbiano ormai consumato quasi tutto il testo pubblico di qualità: libri, Wikipedia, articoli scientifici, codice. È il «Data Wall», il muro dei dati.
La conoscenza che gli umani producono ogni anno cresce più lentamente della fame di dati dei modelli. Così l'industria si è spostata sui dati sintetici: testo prodotto da altre AI per addestrarne di nuove.
Il pericolo si chiama Model Collapse. Un modello nutrito solo di dati fatti da AI, generazione dopo generazione, perde sfumature e varietà: diventa piatto, ripetitivo, incline all'errore.
La via d'uscita è ibrida: i dati sintetici non si usano grezzi, ma filtrati e controllati da un modello verificatore, con i dati umani reali tenuti come ancora per la qualità.
Il testo umano è finito
Modelli sempre più grandi chiedono più dati di quanti il web reale possa offrirne.
Qualità ed equilibrio
Si creano casi rari o di nicchia, come dati medici o finanziari, e si correggono errori e squilibri dei dati veri.
Privacy e diritti d'autore
I dati generati non appartengono a nessuna persona reale: niente norme da violare.
Deep learning · I dati
Al deep learning serve una montagna di dati
Parte da zero e si corregge un pezzetto per volta: più esempi vede, meno sbaglia. Per questo ne divora così tanti.
Deep learning · I dati
Dati di qualità
Non basta la quantità: una rete è brava quanto i dati che ha visto.
Deep learning · La rete
Il neurone artificiale, un piccolo decisore
Da solo fa poco: riceve numeri, li pesa, decide se accendersi. La forza arriva quando sono in tanti.
Deep learning · La rete
Il peso, quello che la rete davvero impara
Ogni collegamento fra due neuroni ha un peso: quanto quel segnale conta. Sono milioni di piccole manopole. Alzarne una vuol dire «questo indizio è importante», abbassarla «lascia perdere». Tutto ciò che la rete sa vive lì, nei pesi, non in regole scritte a mano.
Addestrare una rete non vuol dire scriverle le regole: vuol dire trovare, un po' alla volta, la posizione giusta di tutte le manopole.
Deep learning · La rete
Tanti neuroni, organizzati in strati
I neuroni si collegano in fila, strato dopo strato. Quando quelli nel mezzo sono tanti, la rete è «profonda»: da qui «deep learning».
Deep learning · L'apprendimento
Come impara la rete, prova e correggi
Nessuno le dice la regola giusta: la trova sbagliando e aggiustandosi, un pochino a ogni giro.
Deep learning · L'apprendimento
Andata e ritorno, le due mosse dell'addestramento
Prima la rete prova (andata), poi impara dall'errore tornando indietro a sistemare i pesi (ritorno). Questo doppio passo, ripetuto, è l'addestramento.
Deep learning · Le due fasi
Annotare, poi correggere: l'esempio dello spam
Fase 1 · Annotazione, prima e a mano
Prendiamo 10.000 email grezze. Un gruppo di persone le legge e attacca a ognuna la soluzione giusta, l'etichetta.
«Hai vinto un milione di euro, clicca qui!» diventa 1 (spam). «Ti invio la presentazione per la riunione» diventa 0 (non spam).
Questa etichetta è il bersaglio, il «ground truth», la verità di riferimento. Senza, la rete non potrebbe mai sapere se la risposta che darà è giusta o sbagliata.
Fase 2 · Addestramento, dentro la rete
Andata. La rete legge l'email senza guardare l'etichetta, i calcoli passano per i pesi dei neuroni, e dà una stima: «è spam al 30%» (0,30).
Errore. Confronta la sua stima (0,30) con la verità dell'annotazione (1,00): la distanza è 0,70 di errore.
Ritorno. L'errore torna indietro nella rete e misura quanto ogni peso ha sbagliato. I pesi legati a «vinto» e «clicca qui» si alzano, così la prossima volta il modello le sente come spam.
Tutto questo si ripete per ogni email, epoca dopo epoca.
Le due fasi sono legate: la Fase 2 può correggersi solo grazie all'etichetta creata nella Fase 1. Senza annotazione non c'è errore da misurare, e senza errore la rete non impara.
Approfondimento
Nasce un LLM
Completato l'addestramento, il modello è pronto per essere usato
Fine dell'addestramento
Il modello si cristallizza
Finito il machine learning, i pesi non cambiano più: la conoscenza resta fissata qui dentro, distribuita fra queste due strutture. Da ora il modello non impara, usa quello che ha imparato.
L'inferenza
Una calcolatrice di probabilità
Con i pesi ormai cristallizzati, l'LLM non impara più niente di nuovo. Fa una cosa sola, ma benissimo: indovinare la parola successiva.
È come una calcolatrice di probabilità: dato un testo, calcola quale token ha più probabilità di venire dopo. Questa fase si chiama inferenza.
Seguiamo un esempio dall'inizio alla fine. L'utente scrive una frase lasciata a metà, e il modello deve completarla.
prompt = "Il piatto tipico italiano per eccellenza è la ___"Inferenza · Passo 1
Il taglio in token
Il prompt entra nel tokenizer, il programma esterno che fa da traduttore fra le nostre parole e i numeri del modello.
Prima lo spezza in token, i pezzetti di testo: la nostra frase ne conta otto.
Poi consulta il suo dizionario fisso e cambia ogni token nel suo ID, un numero intero. Il prompt è ora una lista di numeri.
# la frase spezzata in token["Il", " piatto", " tipico", " italiano", " per", " eccellenza", " è", " la"]# ogni token il suo ID[452, 3810, 8920, 4211, 680, 15430, 350, 262]Token e ID qui sono di esempio.
Inferenza · Passo 2
Il recupero delle coordinate
Ogni ID è solo un'etichetta. Per avere il significato, il modello lo usa per pescare una riga nell'Embedding Matrix.
L'ID 452 («Il») riscatta il suo vettore, l'ID 4211 («italiano») il suo, e così per ogni token del prompt.
Da qui il prompt non è più testo: è una matrice di vettori, pronta per i calcoli.
Ora il prompt non è più testo, è una matrice di vettori.
Vettori di esempio: in un modello vero ogni riga ha centinaia di numeri.
Inferenza · Passo 3
Gli strati dei Transformer
La matrice di vettori attraversa tutti gli strati dei Transformer, i pesi interni del modello.
Self-Attention: ogni vettore guarda gli altri. Quello di «la» impara a guardare «piatto», «italiano» ed «eccellenza», e aggiorna le sue coordinate con il contesto.
Il segnale passa di strato in strato, spesso 32, 80 o più. Ogni strato affina il senso della frase.
All'uscita resta un solo vettore finale: il punto esatto in cui la frase si è fermata.
Inferenza · Passo 4
Il calcolo delle probabilità
Il vettore finale passa nell'ultimo strato, l'Unembedding, che lo confronta con tutti i token del vocabolario, anche centomila.
A ognuno assegna una probabilità di essere la parola successiva.
Il modello prende la più alta, «pizza». Con la temperatura può variare un po', per non dire sempre la stessa cosa.
Percentuali di esempio. Vince «pizza», ID 8021.
Inferenza · Il ciclo
Come nasce una frase intera
Il modello non scrive mai tutta la risposta insieme: genera un token alla volta.
Incolla il token appena prodotto in fondo al prompt e ricomincia da capo. Così «la» porta a «pizza», poi «la pizza» porta a una virgola, poi a «famosa».
Va avanti a decine di token al secondo, finché non esce un token speciale di stop, <EOS>, che chiude la frase.
# incolla l'output e ricomincia"… è la" -> "pizza""… è la pizza" -> ",""… la pizza ," -> "famosa""…" -> <EOS>Esempio del ciclo. Il token <EOS> vuol dire fine del testo.